投稿

ラベル(head)が付いた投稿を表示しています

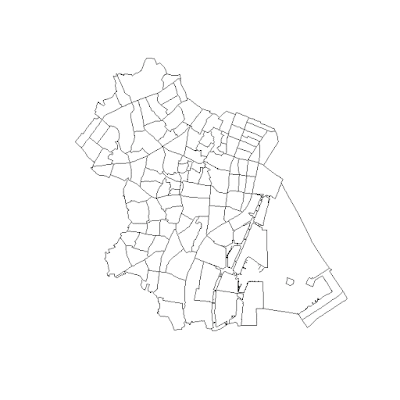
Rを使って郵便番号界の地図を作る(統計局のShape+日本郵便のCSV)
イメージ
郵便番号がどんな感じで割り当てられているか、地図上で確認したかったんです。 GPSで取った地点情報がプライバシーに配慮云々で郵便番号になっていた、なんてことがありまして、その粒度がどんなものか確認したかったってのが発端です。 検索してみても無償のものは意外に見つからないもので、国際航業さんが売っていたりします↓ PAREA-Zip郵便番号界 | 国際航業株式会社 ノースリーブな(=無い袖は振れない)わたくしとしては、自分で作るしかないわけで。 郵便番号のリストは↓ここにありました。 郵便番号データダウンロード - 日本郵便 住所文字列と郵便番号が入っていればどれでもいいんですが、とりあえず、「住所の郵便番号(CSV形式)」の「読み仮名データの促音・拗音を小書きで表記するもの」というのをダウンロードしました。 次は地図です。こういうときに使う境界データとしては、統計局のe-StatでShapeファイルが公開されているので、これが便利。入手の方法は下記を参照。 e-Stat(統計局)で公開されているShapeファイルを、Rで表示する - Rプログラミングの小ネタ 今回は、我らがサラリーマンの聖地 新橋を有する港区を対象にしてみました。 とりあえず地図をプロットするところまでやってみましょう。 library(maptools)     # GIS系のパッケージ # 座標系の情報を持つオブジェクトを作る # longlatは緯度経度指定、WGS84は世界測地系であることを表す pj <- CRS("+proj=longlat +datum=WGS84") # シェープファイルの読み込み map <- readShapePoly("h22ka13103.shp", proj4string=pj) # とりあえずプロット plot(map) shapeをプロットしただけのもの この地図上に追加で郵便番号をプロットすればよさそうですね。 読み込んだシェープファイルにはポリゴンの境界情報だけでなく、それぞれのポリゴンの属性の情報も含まれています。 こうやれば確認できます head(map@data)    ...

所得の分布は対数正規分布に従っているのか?

イメージ
日本の世帯ごとの所得をヒストグラムにすると↓こんな感じになります。 所得金額階級別にみた世帯数の相対度数分布(平成21年調査) 2 所得の分布状況|厚生労働省 より 右側に裾が長く延びているので、正規分布ではないようです。 よく、所得は対数正規分布に従う、なんて聞いたりします。所得額の対数をとってそれで度数分布表を作るような感じですね。 実際に試してみましょう。 グラフで示されていた値を、データ化します。 rate <- 0.01 * c(6.6, 12.7, 13.9, 13.3, 10.0, 8.9, 7.1, 6.2, 5.1, 3.9,                  3.0,  2.1,  1.7,  1.3,  0.9, 0.9, 0.5, 0.4, 0.2, 0.2) income <- seq(50, 1950, 100) df <- data.frame(income, rate) df    income  rate 1      50 0.066 2     150 0.127 3     250 0.139 4     350 0.133 5     450 0.100 6     550 0.089 7     650 0.071 8     750 0.062 9     850 0.051 10    950 0.039 11   1050 0.030 12   1150 0.021 13...

Rのtapply関数を使って、複数の度数分布表・ヒストグラムをまとめて出力する

イメージ
tapplyを使えば、データフレームのカテゴリの列でグループ分けしつつ、値の列に対して関数を適用するということができます。 ・・・と言っても分かりにくいと思いますので、具体的なサンプルをあげてみますと、 > # サンプルデータを作る > 名前 <- c("A", "B",  "C", "D",  "E", "F") > 性別 <- c("男", "男", "女", "男", "女", "女" ) > 身長 <- c(175,  165, 165,  170, 160, 155  ) > df <- data.frame(名前, 性別, 身長) > df   名前 性別 身長 1    A   男  175 2    B   男  165 3    C   女  165 4    D   男  170 5    E   女  160 6    F   女  155 > > # ここから本題 > tapply(df$身長, df$性別, mean)    女  男 160 170 性別でグループ分けして、身長の平均を算出する(mean関数を適用)という感じです。 第3引数にhist関数を指定してやれば、グループ分けを適用したあとに、複数の度数分布表を算出したり、複数の度数分布図(ヒストグラム)を書いたりすることもできます。 もう少し大きいサンプルデータを使いましょう。↓この本に載っていたサンプルを使わせていただきます。 ↓こちらからダウンロードできる、"年収.csv"を使います。 データマイニング入門-Rで学ぶ最新データ解析 - 東京図書 ↓こんな感じのサンプルデータです。 > d <- rea...

Rで放射線モニタリング情報を時系列プロットする

イメージ
データを公開するときはCSV形式みたいに、RAWデータかそれに近い形で提供してくれると、いろいろと利用できて嬉しいですよね。 原子力規制委員会のサイト では、モニタリングポストで測定された空間線量のデータをCSV形式で公開しているので、これを使って時系列データの可視化を試してみましょう。 下記のページで、都道府県やエリア、期間の日付を選択してダウンロードできます。 ダウンロード | 東日本大震災関連情報 放射線モニタリング測定結果等 | 原子力規制委員会 試しに東京都の都健康安全研究センターのモニタリングポストのデータを2014年1月1日~2014年12月31日の1年分ダウンロードしてみました。10分ごとのデータなのでかなりの量ですね。約5.5MBくらいありました。 まずは、読み込んで、冒頭部分を表示。 > d <- read.csv ( "新宿2014.csv" , header=F , as.is=T ) > head ( d ) V1 V2 V3 V4 1 東京都全域 新宿区 都健康安全研究センター 35.70608 139.6987 2 東京都全域 新宿区 都健康安全研究センター 35.70608 139.6987 3 東京都全域 新宿区 都健康安全研究センター 35.70608 139.6987 4 東京都全域 新宿区 都健康安全研究センター 35.70608 139.6987 5 東京都全域 新宿区 都健康安全研究センター 35.70608 139.6987 6 東京都全域 新宿区 都健康安全研究センター 35.70608 139.6987 V5 V6 V7 V8 V9 V10 V11 1 2014 / 12 / 31 23 : 50 0.034 μSv/h 0.061 μSv/h ‐ NA 2 2014 / 12 / 31 23 : 40 0.033 μSv/h 0.059 μSv/h ‐ NA 3 2014 / 12 / 31 23 : 30 0....