投稿

ラベル(text)が付いた投稿を表示しています

Rを使って郵便番号界の地図を作る(統計局のShape+日本郵便のCSV)
イメージ
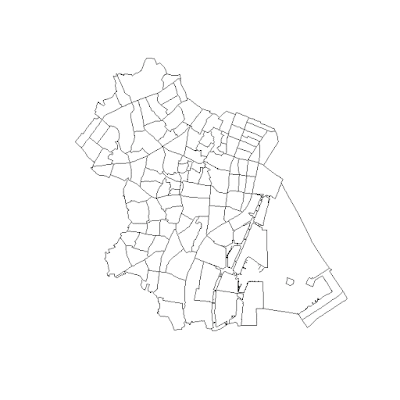
郵便番号がどんな感じで割り当てられているか、地図上で確認したかったんです。 GPSで取った地点情報がプライバシーに配慮云々で郵便番号になっていた、なんてことがありまして、その粒度がどんなものか確認したかったってのが発端です。 検索してみても無償のものは意外に見つからないもので、国際航業さんが売っていたりします↓ PAREA-Zip郵便番号界 | 国際航業株式会社 ノースリーブな(=無い袖は振れない)わたくしとしては、自分で作るしかないわけで。 郵便番号のリストは↓ここにありました。 郵便番号データダウンロード - 日本郵便 住所文字列と郵便番号が入っていればどれでもいいんですが、とりあえず、「住所の郵便番号(CSV形式)」の「読み仮名データの促音・拗音を小書きで表記するもの」というのをダウンロードしました。 次は地図です。こういうときに使う境界データとしては、統計局のe-StatでShapeファイルが公開されているので、これが便利。入手の方法は下記を参照。 e-Stat(統計局)で公開されているShapeファイルを、Rで表示する - Rプログラミングの小ネタ 今回は、我らがサラリーマンの聖地 新橋を有する港区を対象にしてみました。 とりあえず地図をプロットするところまでやってみましょう。 library(maptools)     # GIS系のパッケージ # 座標系の情報を持つオブジェクトを作る # longlatは緯度経度指定、WGS84は世界測地系であることを表す pj <- CRS("+proj=longlat +datum=WGS84") # シェープファイルの読み込み map <- readShapePoly("h22ka13103.shp", proj4string=pj) # とりあえずプロット plot(map) shapeをプロットしただけのもの この地図上に追加で郵便番号をプロットすればよさそうですね。 読み込んだシェープファイルにはポリゴンの境界情報だけでなく、それぞれのポリゴンの属性の情報も含まれています。 こうやれば確認できます head(map@data)    ...
ベンフォードの法則をRでシミュレーションする

イメージ
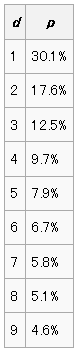
電気料金の請求書の金額の1桁目をたくさん集めて、その分布を見たらどうなっているでしょう。 数字の出方に法則性があるようにも思えないから、1から9まで一様になっているのでは? という気もしますが、そうではないというのがベンフォードの法則です。 ベンフォードの法則 - Wikipedia ベンフォードの法則は、自然界に出てくる多くの(全てのではない)数値の最初の桁の分布が一様ではない、ある特定のものになっているというものである。 (中略) この直感に反するような結果は、電気料金の請求書、住所の番地、株価、人口の数値、死亡率、川の長さ、物理・数学定数、冪乗則で表現されるような過程(自然界ではとても一般的なものである)など、様々な種類の数値の集合に適用できることがわかっている。 どのように偏って分布しているかというと、↓こんな割合になるとのこと。 ベンフォードの法則 - Wikipedia より 本当にそうなるか、Rでシミュレーションしてみましょう。 数値が満たすべき分布について、ウィキペディアには、 論理的には、数値が対数的に分布しているときは常に最初の桁の数値がこのような分布で出現する。 とあります。いまいちピンとこなかったのですが、あわせて掲載されていた図でなんとなく理解しました。 ふむふむ、対数スケールのグラフ上に、見た目で一様になるように分布すればいいのね。 理解を助けるために、まず、対数の数直線を書いてみましょう。 x <- c ( 1 , 10 , 100 , 1000 ) y <- rep ( 0 , length ( x ) ) plot ( x , y , axes=F , xlab= "" , ylab= "" , log = "x" ) abline ( h= 0 ) text ( x , y , x , pos= 1 ) runif関数で発生させた乱数をそのまま使っちゃだめですよね。それでは数値的な一様になってしまいますから。 数直線に指数表記を追加すると分かりやすいです。 a <- round ( log10 ( x ) , 3 ) # 指数の肩の数字...

所得の分布は対数正規分布に従っているのか?

イメージ
日本の世帯ごとの所得をヒストグラムにすると↓こんな感じになります。 所得金額階級別にみた世帯数の相対度数分布(平成21年調査) 2 所得の分布状況|厚生労働省 より 右側に裾が長く延びているので、正規分布ではないようです。 よく、所得は対数正規分布に従う、なんて聞いたりします。所得額の対数をとってそれで度数分布表を作るような感じですね。 実際に試してみましょう。 グラフで示されていた値を、データ化します。 rate <- 0.01 * c(6.6, 12.7, 13.9, 13.3, 10.0, 8.9, 7.1, 6.2, 5.1, 3.9,                  3.0,  2.1,  1.7,  1.3,  0.9, 0.9, 0.5, 0.4, 0.2, 0.2) income <- seq(50, 1950, 100) df <- data.frame(income, rate) df    income  rate 1      50 0.066 2     150 0.127 3     250 0.139 4     350 0.133 5     450 0.100 6     550 0.089 7     650 0.071 8     750 0.062 9     850 0.051 10    950 0.039 11   1050 0.030 12   1150 0.021 13...

Rで対応のあるデータを比較する

イメージ
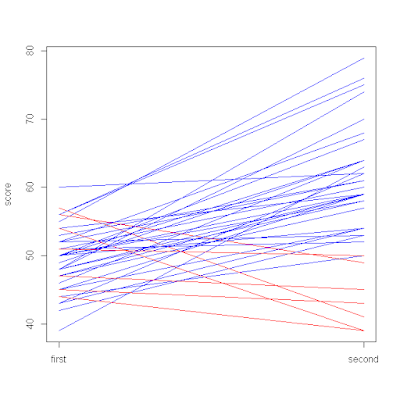
例えば↓こんなデータがあったとします。40人のクラスがあって、1度目のテスト実施後に、なんらかの施策をして、その後、2度目のテストを実施したと。で、施策の効果は点数に表れているのか? みたいなのを想像していただけると理解しやすいかと。行名の 1, 2, ... , 40 はその学生の出席番号みたいなイメージで。 > df    first second 1     56     75 2     50     59 3     53     61 4     60     62 5     45     59 6     51     60 7     48     70 8     55     79 9     50     67 10    44     50 11    50     64 12    56     49 13    42     53 14    52     53 15    57     ...

Rでヒストグラムの上に度数の数字を表示する

イメージ
例えば、↓こんなヒストグラムがあったとしましょう。 普通にhist関数で描画したもの。 30~40、40~50の階級の度数はゼロ? ぱっと見、30~40と40~50の階級の度数はゼロなんだな、と見えちゃいますが、そうではありません。 ↓実はこんなスクリプトでサンプルデータを作ったので、 d <- c ( rep ( 5 , 10000 ) , rep ( 15 , 1000 ) , rep ( 25 , 100 ) , rep ( 35 , 10 ) , rep ( 45 , 1 ) ) hist ( d , breaks= seq ( 0 , 50 , 10 ) ) 30~40の階級には10の度数、40~50の階級には1の度数があるんですよね。でも、0~10の階級の10000の度数が多すぎるために、つぶれて見えなくなってしまったという状態。 こんなときは、棒グラフの上のところに度数の数字を表示させてやれば、少ない度数の階級についても確認ができます。 hist ( d , breaks= seq ( 0 , 50 , 10 ) , labels =T ) hist関数にlabels=Tオプションを指定し、度数を表示させたもの labels=T オプションを指定するだけなので、とても簡単です。 が、実は私、このオプションの存在を知らず、いままで↓下記のような方法で書いてました。(このへんの紆余曲折が、この記事を書こうと思い立った理由だったりします) h <- hist ( d , breaks= seq ( 0 , 50 , 10 ) ) text ( h$mids , h$counts , h$counts ) hist関数の戻り値を、text関数を使ってプロット hist関数の戻り値(変数hに格納してます)には、階級値や度数の情報が入っているので、それをtext関数で表示させるというもの。 文字と棒グラフのborderが重なって見にくいと思う場合は、↓こうやればOK。 h <- hist ( d , breaks= seq ( 0 , 50 , 10 ) , ylim= c ( 0 , 10100 ) ) ...

Rで円を描く方法あれこれ

イメージ
グラフに円を描くような関数が用意されていてもよさそうなものですが、どうもないみたいですので、自力で描く必要がありそうです。 簡単のため、半径1の円の例です。 まず思いつくのは、   x^2 + y^2 = 1 をyについて解いて、   y = ±√(1 - x^2) という関数の形にして、curve関数を使って描く方法でしょうか↓ curve関数で上側と下側を別々に描く curve ( sqrt ( 1 -x^ 2 ) , xlim= c ( - 1 , 1 ) , ylim= c ( - 1 , 1 ) , asp= 1 ) curve ( - sqrt ( 1 -x^ 2 ) , xlim= c ( - 1 , 1 ) , ylim= c ( - 1 , 1 ) , add=T ) 媒介変数表示を使うやり方もありますね。  x = cosθ  y = sinθ の、x と y の組を plotしていく感じです↓ 媒介変数で座標を求めたあとにプロット theta <- seq ( - pi , pi , length = 100 ) plot ( cos ( theta ) , sin ( theta ) , type= "l" , asp= 1 ) ちなみに type=l オプションを忘れると↓こんな感じになります。 点でプロットすると理屈が分かりやすい plot ( cos ( theta ) , sin ( theta ) , asp= 1 ) 何度も使う場合は、中心座標や半径を引数として関数化しておくといいですね↓ こんなところに隠れミッキーが!(自分で描いたくせに) plot.circle <- function ( x , y , r ) { theta <- seq ( - pi , pi , length = 100 ) points ( x + r* cos ( theta ) , y + r* sin ( theta ) , type= "l" , asp= 1 ) } plot ( c ( -...