投稿

ラベル(rnorm)が付いた投稿を表示しています

Rでヒストグラムの一部に色をつける(colオプション指定で可)

イメージ
「R ヒストグラム 一部 色をつける」で検索してみると、hist関数でヒストグラムを描いた後に、polygon関数で色をつける、なんて方法がヒットしました。 polygon使えばなんでもできそうだけど、なんか、ちょっと違うよなあ、とか思ってしまいまして。 で、実はhist関数のcolオプションでも、できるんですよね。 colオプションに1つの値(スカラー)を指定すると、全体が一色で塗りつぶされてしまいますが、ここにベクトルを指定すると、それぞれの棒の色を指定することができます。 例えば、ヒストグラムに10個のビンがあって、それぞれを任意の色で塗りたい場合は、10個の要素を持つベクトルをcolオプションに指定すればOKです。 set.seed(0)       # 再現性のために rd <- rnorm(100) # 100個の乱数 cols <- c("white", "white", "red"  , "white", "white",           "blue" , "white", "white", "white", "white") hist(rd, col=cols) ヒストグラムの一部に色をつける 色を塗りたくない場合は(パワポなどの「塗りつぶしなし」みたいな感じ)、色名の代わりにNAを指定すればいいです。 cols <- c(NA    , NA, "red", NA, NA,           "blue", NA, NA   , NA, NA) hist(rd, col=cols) 最初の例と全く同じ見た目になると思いますが、add=T指定で重ねたときなんかに差がでますね。 階級がいっぱいあって、いちいち全部書き出すのが面倒なときは、下記のような感じで、塗りたいところだけを指定すればいいですね。 cols <- rep("white", 100) # ”white”を詰めた、長めのベクトルを作って...

Rのhistとggplot(geom_histogram)を比較する

イメージ
ggplot2パッケージって使ったことありませんでした。記法がとっつきにくいというのもあったのですが、あの見た目を素直に「きれい」とは認めたくなかったというか。「ggplotの方がかっこいい」という人への反発みたいな部分も多分にあるのですが。 「白地に線画」みたいなビジュアルが好きなんです。下手に色をつけたらかえって趣味が悪くなったりするじゃないですか。自分自身センスがないことを自覚しているので、色やら塗りつぶしやら飾りっぽいものやらは極力使わないようにしていたんですよね。 でも今回、ggplot2パッケージを使ってみようと思ったのは、ベースとなるレイヤーを用意して、次に重ねたいレイヤーを(場合によっては複数)用意して、最後にバンっとplotする、っていうコンセプトがなんだか使いやすいのではないかという気がしたから。なので、徐々に試していこうかなと思っています。 前置きが長くなりました。 今回はヒストグラムですが、多くの人に馴染みのあるデフォルトのhistでの描画と、ggplot2パッケージを使った場合とで、どんな風に違うのか試してみました。 正規分布に従う乱数を発生させて、普通にヒストグラムを描いてみます。 data1 <- rnorm ( 1000 )   hist ( data1 ) 通常のhist関数で描画 ggplot2パッケージを使うと↓こんな描き方になります。 install.packages ( "ggplot2" ) library ( ggplot2 )   df1 <- data.frame ( data1 ) # データフレームにしておく必要がある   g <- ggplot ( df1 , aes ( x=data1 ) ) # 対象がdata1列であることを指定 g <- g + geom_histogram ( ) # ヒストグラムを描画することを指定 plot ( g ) # 描画 ggplot2パッケージを使ったもの 先ほどの、デフォルトのhistと階級幅を合わせる(=0.5)には、binwidthを指定します↓ g ...

Rで最頻値(mode)を求める ~連続値データの場合~

イメージ
Rで最頻値を求める方法として、よく見かけるのがtable関数を使った方法です↓ names(which.max(table(x))) 離散値データの場合は上記でうまくいくのですが、連続値データの場合はうまくいきません。 また離散値データであっても、取りうる値の種類に対してサンプルサイズが小さい場合もうまくいきません。 具体例をあげてみます。40人学級でのテストの点数をイメージしました。 # テストの点数っぽいサンプルデータを作る set.seed(4) # (やや恣意的な)再現性のために x <- round(rnorm(n=40, mean=50, sd=15)) x  [1] 53 42 63 59 75 60 31 47 78 77 58 50 56 49 51 53 67 49 48 46 [21] 73 52 70 69 59 46 69 64 36 69 52 66 39 28 63 44 47 64 43 40 上記データに対して、tableを使って最頻値を求めると、 names(which.max(table(x))) [1] "69" 想定している、"50"とかなりずれた値が出てしまいました。実現値がスパースなので、個別に最も現れた値を出すことに意味がないんですね。 ↓階級を1点刻みにしたヒストグラムで見るとよく分かります。 # 1点刻みでヒストグラムを描く hist(x, breaks=seq(20,80,1)) 69点を取った人は3人で最も多いですが、たまたま感がありますよね。50点の周辺の方が頻度が高いように思えます。 すなおに階級に幅を持たせると、予想と近い最頻値が得られます。 # 階級幅はデフォルト(hist関数にまかせる) hist(x) 上記の場合、40~50の階級が最も度数が多いので、この中間値を階級値として「最頻値は45である」という結論は直感に反していないと思われます。 階級値をきりのいい数字にしたい場合は、↓breaksを指定してやればOKです。 hist(x, breaks=seq(25, 85, 10)) 最頻値は50の階級であるという、予想通りの結果となりました。 つまり、連続値(や...

所得の分布は対数正規分布に従っているのか?

イメージ
日本の世帯ごとの所得をヒストグラムにすると↓こんな感じになります。 所得金額階級別にみた世帯数の相対度数分布(平成21年調査) 2 所得の分布状況|厚生労働省 より 右側に裾が長く延びているので、正規分布ではないようです。 よく、所得は対数正規分布に従う、なんて聞いたりします。所得額の対数をとってそれで度数分布表を作るような感じですね。 実際に試してみましょう。 グラフで示されていた値を、データ化します。 rate <- 0.01 * c(6.6, 12.7, 13.9, 13.3, 10.0, 8.9, 7.1, 6.2, 5.1, 3.9,                  3.0,  2.1,  1.7,  1.3,  0.9, 0.9, 0.5, 0.4, 0.2, 0.2) income <- seq(50, 1950, 100) df <- data.frame(income, rate) df    income  rate 1      50 0.066 2     150 0.127 3     250 0.139 4     350 0.133 5     450 0.100 6     550 0.089 7     650 0.071 8     750 0.062 9     850 0.051 10    950 0.039 11   1050 0.030 12   1150 0.021 13...

Rでシミュレーション(正規分布に従う確率変数の和は正規分布に従う)

イメージ
「シミュレーション」なんていうと、難しそうな気がしてしまいますが、今回のは「乱数を使って試してみる」くらいのものです。 例えば、10万人の学生がいます。彼らの身長は正規分布に従っているとします。また、彼らのテストの点数も正規分布に従っているとします。 このとき、「身長+点数」という確率変数を考えると、これは正規分布に従っているでしょうか? これを数学的に証明するのではなく、乱数を使ったシミュレーションで、「身長+点数もきっと正規分布に従うんじゃないか」ということを確認しようというわけです。 まずは↓こんな感じでデータを生成しておきます。 # 身長 # 平均 :170cm # 標準偏差: 5cm heights <- rnorm ( 100000 , 170 , 5 )   # 点数 # 平均 : 50 # 標準偏差: 10 scores <- rnorm ( 100000 , 50 , 10 ) ↓身長と点数のそれぞれでヒストグラムを描いてみましょう。 brk <- seq ( 0 , 300 , 1 ) # ヒストグラムの刻み hist ( heights , breaks=brk , ylim= c ( 0 , 10000 ) ) 正規分布に従う「身長」のヒストグラム hist ( scores , breaks=brk , ylim= c ( 0 , 10000 ) ) 正規分布に従う「点数」のヒストグラム ↓両者を足してヒストグラムを描いてみると、 hist ( heights + scores , breaks=brk , ylim= c ( 0 , 10000 ) ) 「身長+点数」は正規分布に従うか? どうやら正規分布になっているっぽいです。 では、どんな正規分布(平均、分散)になっているのでしょうか。 > mean(heights) [1] 169.9721 > mean(scores) [1] 50.04487 > mean(heights + scores) [1] 220.017 「身長...

Rで複数のヒストグラムを比較する方法あれこれ

イメージ
2つ以上のヒストグラムを1つのグラフ上に描画して、比較したいようなときってありますよね。 例えば、集団aのテストの点数と、集団bのテストの点数が、それぞれ1000件ずつあるとしましょう。 # サンプルデータを作っておく a <- rnorm ( 1000 , 40 , 10 ) b <- rnorm ( 1000 , 60 , 10 ) borderオプションを使って、ヒストグラムの線に色をつけるってのは1つのやり方ですね↓ # 線に色をつける hist ( a , breaks= seq ( 0 , 100 , 5 ) , border= "red" , xlim= c ( 0 , 100 ) , main= "" , xlab= "" ) hist ( b , breaks= seq ( 0 , 100 , 5 ) , border= "blue" , add=T ) borderオプションでヒストグラムの線に色をつける なんとなく見えてはいるのですが、重なった縦線は後から描画した方で上書きされてしまい、そのへんがちょっと見にくいですね。 colオプションで面に色をつけることもできますが・・・ # 色で塗りつぶす hist ( a , breaks= seq ( 0 , 100 , 5 ) , col = "red" , xlim= c ( 0 , 100 ) , main= "" , xlab= "" ) hist ( b , breaks= seq ( 0 , 100 , 5 ) , col = "blue" , add=T ) colオプションでヒストグラムを塗りつぶす ↑普通の色で塗っちゃうと重なったところが見えなくなってしまいます。 そういうときは、透過色を使えばいいです↓ # 透過色を使う hist ( a , breaks= seq ( 0 , 100 , 5 ) , col = "#FF00007F" , x...

Rでカイ二乗分布の確率密度関数のグラフをシミュレーション的に描く

イメージ
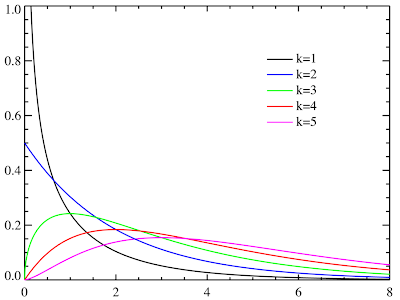
カイ二乗分布といえば、独立性の検定や適合度の検定で使ったりしますよね。 ウィキペディア には、確率密度関数のグラフが載っていて↓こんな感じ。 カイ二乗分布の確率密度関数のグラフ このグラフをRで描いてみようと、確率密度関数の式を見てみると、 ↑こんなのが載っていて、なんだかすごくむつかしい。Γ(ガンマ)関数ってのが出てきて、さらにそれは積分の形で定義されていたりして。 でもまあ、そのへんは理解できなくても、Rにはカイ二乗分布の確率密度関数(dchisq)が用意されているので、下記のようにすれば、ウィキペディアに載っていたのとそっくりのグラフが描けます。 curve ( dchisq ( x , 1 ) , xlim= c ( 0 , 8 ) , ylim= c ( 0 , 1 ) , col = "black" , ylab= "dchisq(x, k)" ) curve ( dchisq ( x , 2 ) , xlim= c ( 0 , 8 ) , ylim= c ( 0 , 1 ) , col = "blue" , add=T ) curve ( dchisq ( x , 3 ) , xlim= c ( 0 , 8 ) , ylim= c ( 0 , 1 ) , col = "green" , add=T ) curve ( dchisq ( x , 4 ) , xlim= c ( 0 , 8 ) , ylim= c ( 0 , 1 ) , col = "red" , add=T ) curve ( dchisq ( x , 5 ) , xlim= c ( 0 , 8 ) , ylim= c ( 0 , 1 ) , col = "magenta" , add=T )   #凡例 legend ( "topright" , lty= 1 , legend = c ( "k=1" , "k=2" , "k=3" , ...

Rで度数分布表を作る

イメージ
まずは今回のサンプル用として、身長っぽいデータを作ってみます。 a <- round ( rnorm ( 30 , mean = 170 , sd = 5 ) , 1 ) a   [ 1 ] 173.0 168.6 168.5 164.2 167.3 170.6 162.7 168.0 170.8 [ 10 ] 175.7 166.0 166.5 162.4 172.6 170.1 170.2 164.2 167.1 [ 19 ] 163.8 163.4 168.1 168.7 171.1 164.6 166.3 177.0 170.0 [ 28 ] 173.3 170.7 169.0 このaに対して、度数分布表を作りたい。 質的データ(カテゴリカルデータ)なら、table関数を使って度数を集計できるのですが、量的データに対してtableを使うと、↓こんな感じになってしまいます。 table ( a )   a 162.4 162.7 163.4 163.8 164.2 164.6 166 166.3 166.5 167.1 1 1 1 1 2 1 1 1 1 1 167.3 168 168.1 168.5 168.6 168.7 169 170 170.1 170.2 1 1 1 1 1 1 1 1 1 1 170.6 170.7 170.8 171.1 172.6 173 173.3 175.7 177 1 1 1 1 1 1 1 1 1 量的データだとうまくいかないですね。 Rには、お馴染みhist関数があるんで、ヒストグラムは簡単に描けます。 hist ( a ) 実は、このhist関数の戻り値のオブジェクトに各階級の度...