投稿

ラベル(c)が付いた投稿を表示しています

Rでブートストラップ法

イメージ
「ブートストラップ」という言葉は聞いたことはあるけど、具体的にどんなことなのかはよく知らない、というのが私のレベルです。 が、「統計学入門」(東京大学教養学部統計学教室 編)という教科書↓ 統計学入門 (基礎統計学) の中の演習問題に出てきた(でも、教科書の本編には解説はない)ので、Rでちょっとやってみました。 第3章 練習問題 3.4 <ブートストラップ> 以下の手法をパソコンで行え。 i)  [1, 11]に属する、整数の乱数を発生させる手続きを考えよ。 ii)  i)を11回繰返して実行し、11個のランダムな番号を得たのち、表3.1、図3.1のデータからその番号のデータを取り出し(ただし、同一番号があれば重複して取り出し、そのデータは複数個あると考える)、相関係数rを計算せよ。 iii) ii)を200通り繰返し、相関係数の値 r1, r2, ..., r200 を得たとき、そのヒストグラムを作れ。以上の統計手法を ブートストラップ という。 「表3.1、図3.1」というのは、教科書の本編のところに出てきた表と図で、相関関係が認められる例として紹介されていたものです。 統計学入門 (基礎統計学) より 統計学入門 (基礎統計学) より このデータを使う必要があるので、まずは入力しましょう。 > bro <- c(71, 68, 66, 67, 70, 71, 70, 73, 72, 65, 66) > sis <- c(69, 64, 65, 63, 65, 62, 65, 64, 66, 59, 62) 書籍に載っていた図と同じような感じでプロットしてみました↓ > plot(bro, sis, xlim=c(68,70), ylim=c(59,70), asp=1, pch=16) 書籍に載っていたデータをRでプロットしたもの 書籍に出てくる図とほぼ同じものができました。ただ、点が10個しかなく1個少ないです。これは(70, 65)という全く同じデータが2つあって同じ座標にプロットされているためです。書籍の方では少しずらして、分かるようになっていました。 あと、書籍だと(64,62)あたりに点がありますが(一番左側のもの)、これは間...
ベンフォードの法則をRでシミュレーションする

イメージ
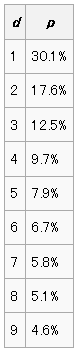
電気料金の請求書の金額の1桁目をたくさん集めて、その分布を見たらどうなっているでしょう。 数字の出方に法則性があるようにも思えないから、1から9まで一様になっているのでは? という気もしますが、そうではないというのがベンフォードの法則です。 ベンフォードの法則 - Wikipedia ベンフォードの法則は、自然界に出てくる多くの(全てのではない)数値の最初の桁の分布が一様ではない、ある特定のものになっているというものである。 (中略) この直感に反するような結果は、電気料金の請求書、住所の番地、株価、人口の数値、死亡率、川の長さ、物理・数学定数、冪乗則で表現されるような過程(自然界ではとても一般的なものである)など、様々な種類の数値の集合に適用できることがわかっている。 どのように偏って分布しているかというと、↓こんな割合になるとのこと。 ベンフォードの法則 - Wikipedia より 本当にそうなるか、Rでシミュレーションしてみましょう。 数値が満たすべき分布について、ウィキペディアには、 論理的には、数値が対数的に分布しているときは常に最初の桁の数値がこのような分布で出現する。 とあります。いまいちピンとこなかったのですが、あわせて掲載されていた図でなんとなく理解しました。 ふむふむ、対数スケールのグラフ上に、見た目で一様になるように分布すればいいのね。 理解を助けるために、まず、対数の数直線を書いてみましょう。 x <- c ( 1 , 10 , 100 , 1000 ) y <- rep ( 0 , length ( x ) ) plot ( x , y , axes=F , xlab= "" , ylab= "" , log = "x" ) abline ( h= 0 ) text ( x , y , x , pos= 1 ) runif関数で発生させた乱数をそのまま使っちゃだめですよね。それでは数値的な一様になってしまいますから。 数直線に指数表記を追加すると分かりやすいです。 a <- round ( log10 ( x ) , 3 ) # 指数の肩の数字...

Rの正規表現で最短マッチ(最短一致)させる

特にRに固有のことというわけではありませんし、正規表現に詳しい人にとっては当たり前のことだとは思いますが、私自身が結構つまづいたので・・・ ↓こんな感じのベクトル(住所リストのイメージ)があったとします。 住所リスト <- c( "佐藤町中村1-2",                  "高橋町新田2-3",                  "佐々木町本町3-4",                  "伊藤町原4-5",                  "山本町町田5-6",                  "長谷川町本郷6-7" ) 住所リスト [1] "佐藤町中村1-2"   "高橋町新田2-3"   "佐々木町本町3-4" [4] "伊藤町原4-5"     "山本町町田5-6"   "長谷川町本郷6-7" で、それぞれから冒頭の「○○町」の部分を取り除きたいとします。 町名の長さも一律ではないので、こういうときは正規表現が便利ですよね。 私が最初に思いついた正規表現が以下です。 sub(" ^.+町 ", "", 住所リスト, useBytes=F) 冒頭( ^ )から、任意の文字( . )が、1つ以上( + )あって、「 町 」で終わるような文字列、というつもりで...

所得の分布は対数正規分布に従っているのか?

イメージ
日本の世帯ごとの所得をヒストグラムにすると↓こんな感じになります。 所得金額階級別にみた世帯数の相対度数分布(平成21年調査) 2 所得の分布状況|厚生労働省 より 右側に裾が長く延びているので、正規分布ではないようです。 よく、所得は対数正規分布に従う、なんて聞いたりします。所得額の対数をとってそれで度数分布表を作るような感じですね。 実際に試してみましょう。 グラフで示されていた値を、データ化します。 rate <- 0.01 * c(6.6, 12.7, 13.9, 13.3, 10.0, 8.9, 7.1, 6.2, 5.1, 3.9,                  3.0,  2.1,  1.7,  1.3,  0.9, 0.9, 0.5, 0.4, 0.2, 0.2) income <- seq(50, 1950, 100) df <- data.frame(income, rate) df    income  rate 1      50 0.066 2     150 0.127 3     250 0.139 4     350 0.133 5     450 0.100 6     550 0.089 7     650 0.071 8     750 0.062 9     850 0.051 10    950 0.039 11   1050 0.030 12   1150 0.021 13...

片側検定/両側検定の選択が恣意的な気がする件をRのt検定で確認

こんな例を考えます。 10人の元々のテストの平均点は50点でした。点数をあげる施策を行った後、再度テストをしてみると、 after <- c(44, 47, 48, 51, 54, 56, 59, 62, 63, 65) という点数が得られました。施策は効果があったかどうかを、有意水準5%で検定しましょう。 【Aさんの検定】 Aさんは施策に懐疑的でした。場合によっては施策の悪影響が出て、 点数が下がる可能性もある と考えていますので、 両側検定 を行います。 > t.test(after, mu=50,  alternative="two.sided")         One Sample t-test data:  after t = 2.1198, df = 9, p-value = 0.06306 alternative hypothesis: true mean is not equal to 50 95 percent confidence interval:  49.67088 60.12912 sample estimates: mean of x      54.9 p値が0.05よりも大きいので、 帰無仮説は棄却できず、「施策は効果があるとは言えない」 と結論付けました。 【Bさんの検定】 Bさんは施策の効果を確信していました。 点数が下がることはありえない と考えていますので、 片側検定 を行います。 > t.test(after, mu=50,  alternative="greater")         One Sample t-test data:  after t = 2.1198, df = 9, p-value = 0.03153 alternative hypothesis: true mean is greater than 50 95 percent confidence interval:  50.66264    ...

Rで対応のあるデータを比較する

イメージ
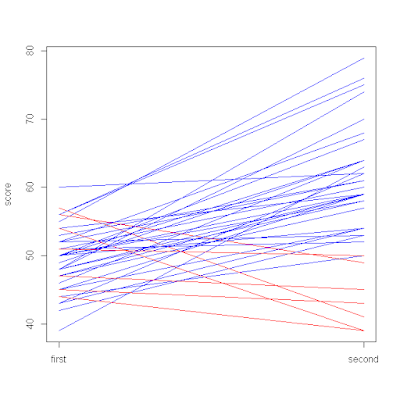
例えば↓こんなデータがあったとします。40人のクラスがあって、1度目のテスト実施後に、なんらかの施策をして、その後、2度目のテストを実施したと。で、施策の効果は点数に表れているのか? みたいなのを想像していただけると理解しやすいかと。行名の 1, 2, ... , 40 はその学生の出席番号みたいなイメージで。 > df    first second 1     56     75 2     50     59 3     53     61 4     60     62 5     45     59 6     51     60 7     48     70 8     55     79 9     50     67 10    44     50 11    50     64 12    56     49 13    42     53 14    52     53 15    57     ...

Rでヒストグラムの上に度数の数字を表示する

イメージ
例えば、↓こんなヒストグラムがあったとしましょう。 普通にhist関数で描画したもの。 30~40、40~50の階級の度数はゼロ? ぱっと見、30~40と40~50の階級の度数はゼロなんだな、と見えちゃいますが、そうではありません。 ↓実はこんなスクリプトでサンプルデータを作ったので、 d <- c ( rep ( 5 , 10000 ) , rep ( 15 , 1000 ) , rep ( 25 , 100 ) , rep ( 35 , 10 ) , rep ( 45 , 1 ) ) hist ( d , breaks= seq ( 0 , 50 , 10 ) ) 30~40の階級には10の度数、40~50の階級には1の度数があるんですよね。でも、0~10の階級の10000の度数が多すぎるために、つぶれて見えなくなってしまったという状態。 こんなときは、棒グラフの上のところに度数の数字を表示させてやれば、少ない度数の階級についても確認ができます。 hist ( d , breaks= seq ( 0 , 50 , 10 ) , labels =T ) hist関数にlabels=Tオプションを指定し、度数を表示させたもの labels=T オプションを指定するだけなので、とても簡単です。 が、実は私、このオプションの存在を知らず、いままで↓下記のような方法で書いてました。(このへんの紆余曲折が、この記事を書こうと思い立った理由だったりします) h <- hist ( d , breaks= seq ( 0 , 50 , 10 ) ) text ( h$mids , h$counts , h$counts ) hist関数の戻り値を、text関数を使ってプロット hist関数の戻り値(変数hに格納してます)には、階級値や度数の情報が入っているので、それをtext関数で表示させるというもの。 文字と棒グラフのborderが重なって見にくいと思う場合は、↓こうやればOK。 h <- hist ( d , breaks= seq ( 0 , 50 , 10 ) , ylim= c ( 0 , 10100 ) ) ...