投稿

ラベル(round)が付いた投稿を表示しています

ベンフォードの法則をRでシミュレーションする
イメージ
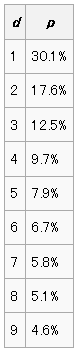
電気料金の請求書の金額の1桁目をたくさん集めて、その分布を見たらどうなっているでしょう。 数字の出方に法則性があるようにも思えないから、1から9まで一様になっているのでは? という気もしますが、そうではないというのがベンフォードの法則です。 ベンフォードの法則 - Wikipedia ベンフォードの法則は、自然界に出てくる多くの(全てのではない)数値の最初の桁の分布が一様ではない、ある特定のものになっているというものである。 (中略) この直感に反するような結果は、電気料金の請求書、住所の番地、株価、人口の数値、死亡率、川の長さ、物理・数学定数、冪乗則で表現されるような過程(自然界ではとても一般的なものである)など、様々な種類の数値の集合に適用できることがわかっている。 どのように偏って分布しているかというと、↓こんな割合になるとのこと。 ベンフォードの法則 - Wikipedia より 本当にそうなるか、Rでシミュレーションしてみましょう。 数値が満たすべき分布について、ウィキペディアには、 論理的には、数値が対数的に分布しているときは常に最初の桁の数値がこのような分布で出現する。 とあります。いまいちピンとこなかったのですが、あわせて掲載されていた図でなんとなく理解しました。 ふむふむ、対数スケールのグラフ上に、見た目で一様になるように分布すればいいのね。 理解を助けるために、まず、対数の数直線を書いてみましょう。 x <- c ( 1 , 10 , 100 , 1000 ) y <- rep ( 0 , length ( x ) ) plot ( x , y , axes=F , xlab= "" , ylab= "" , log = "x" ) abline ( h= 0 ) text ( x , y , x , pos= 1 ) runif関数で発生させた乱数をそのまま使っちゃだめですよね。それでは数値的な一様になってしまいますから。 数直線に指数表記を追加すると分かりやすいです。 a <- round ( log10 ( x ) , 3 ) # 指数の肩の数字...

Rで最頻値(mode)を求める ~連続値データの場合~

イメージ
Rで最頻値を求める方法として、よく見かけるのがtable関数を使った方法です↓ names(which.max(table(x))) 離散値データの場合は上記でうまくいくのですが、連続値データの場合はうまくいきません。 また離散値データであっても、取りうる値の種類に対してサンプルサイズが小さい場合もうまくいきません。 具体例をあげてみます。40人学級でのテストの点数をイメージしました。 # テストの点数っぽいサンプルデータを作る set.seed(4) # (やや恣意的な)再現性のために x <- round(rnorm(n=40, mean=50, sd=15)) x  [1] 53 42 63 59 75 60 31 47 78 77 58 50 56 49 51 53 67 49 48 46 [21] 73 52 70 69 59 46 69 64 36 69 52 66 39 28 63 44 47 64 43 40 上記データに対して、tableを使って最頻値を求めると、 names(which.max(table(x))) [1] "69" 想定している、"50"とかなりずれた値が出てしまいました。実現値がスパースなので、個別に最も現れた値を出すことに意味がないんですね。 ↓階級を1点刻みにしたヒストグラムで見るとよく分かります。 # 1点刻みでヒストグラムを描く hist(x, breaks=seq(20,80,1)) 69点を取った人は3人で最も多いですが、たまたま感がありますよね。50点の周辺の方が頻度が高いように思えます。 すなおに階級に幅を持たせると、予想と近い最頻値が得られます。 # 階級幅はデフォルト(hist関数にまかせる) hist(x) 上記の場合、40~50の階級が最も度数が多いので、この中間値を階級値として「最頻値は45である」という結論は直感に反していないと思われます。 階級値をきりのいい数字にしたい場合は、↓breaksを指定してやればOKです。 hist(x, breaks=seq(25, 85, 10)) 最頻値は50の階級であるという、予想通りの結果となりました。 つまり、連続値(や...

所得の分布は対数正規分布に従っているのか?

イメージ
日本の世帯ごとの所得をヒストグラムにすると↓こんな感じになります。 所得金額階級別にみた世帯数の相対度数分布(平成21年調査) 2 所得の分布状況|厚生労働省 より 右側に裾が長く延びているので、正規分布ではないようです。 よく、所得は対数正規分布に従う、なんて聞いたりします。所得額の対数をとってそれで度数分布表を作るような感じですね。 実際に試してみましょう。 グラフで示されていた値を、データ化します。 rate <- 0.01 * c(6.6, 12.7, 13.9, 13.3, 10.0, 8.9, 7.1, 6.2, 5.1, 3.9,                  3.0,  2.1,  1.7,  1.3,  0.9, 0.9, 0.5, 0.4, 0.2, 0.2) income <- seq(50, 1950, 100) df <- data.frame(income, rate) df    income  rate 1      50 0.066 2     150 0.127 3     250 0.139 4     350 0.133 5     450 0.100 6     550 0.089 7     650 0.071 8     750 0.062 9     850 0.051 10    950 0.039 11   1050 0.030 12   1150 0.021 13...

Rで度数分布表を作る

イメージ
まずは今回のサンプル用として、身長っぽいデータを作ってみます。 a <- round ( rnorm ( 30 , mean = 170 , sd = 5 ) , 1 ) a   [ 1 ] 173.0 168.6 168.5 164.2 167.3 170.6 162.7 168.0 170.8 [ 10 ] 175.7 166.0 166.5 162.4 172.6 170.1 170.2 164.2 167.1 [ 19 ] 163.8 163.4 168.1 168.7 171.1 164.6 166.3 177.0 170.0 [ 28 ] 173.3 170.7 169.0 このaに対して、度数分布表を作りたい。 質的データ(カテゴリカルデータ)なら、table関数を使って度数を集計できるのですが、量的データに対してtableを使うと、↓こんな感じになってしまいます。 table ( a )   a 162.4 162.7 163.4 163.8 164.2 164.6 166 166.3 166.5 167.1 1 1 1 1 2 1 1 1 1 1 167.3 168 168.1 168.5 168.6 168.7 169 170 170.1 170.2 1 1 1 1 1 1 1 1 1 1 170.6 170.7 170.8 171.1 172.6 173 173.3 175.7 177 1 1 1 1 1 1 1 1 1 量的データだとうまくいかないですね。 Rには、お馴染みhist関数があるんで、ヒストグラムは簡単に描けます。 hist ( a ) 実は、このhist関数の戻り値のオブジェクトに各階級の度...