投稿

ラベル(seq)が付いた投稿を表示しています

所得の分布は対数正規分布に従っているのか?

イメージ
日本の世帯ごとの所得をヒストグラムにすると↓こんな感じになります。 所得金額階級別にみた世帯数の相対度数分布(平成21年調査) 2 所得の分布状況|厚生労働省 より 右側に裾が長く延びているので、正規分布ではないようです。 よく、所得は対数正規分布に従う、なんて聞いたりします。所得額の対数をとってそれで度数分布表を作るような感じですね。 実際に試してみましょう。 グラフで示されていた値を、データ化します。 rate <- 0.01 * c(6.6, 12.7, 13.9, 13.3, 10.0, 8.9, 7.1, 6.2, 5.1, 3.9,                  3.0,  2.1,  1.7,  1.3,  0.9, 0.9, 0.5, 0.4, 0.2, 0.2) income <- seq(50, 1950, 100) df <- data.frame(income, rate) df    income  rate 1      50 0.066 2     150 0.127 3     250 0.139 4     350 0.133 5     450 0.100 6     550 0.089 7     650 0.071 8     750 0.062 9     850 0.051 10    950 0.039 11   1050 0.030 12   1150 0.021 13...

Rでシミュレーション(正規分布に従う確率変数の和は正規分布に従う)

イメージ
「シミュレーション」なんていうと、難しそうな気がしてしまいますが、今回のは「乱数を使って試してみる」くらいのものです。 例えば、10万人の学生がいます。彼らの身長は正規分布に従っているとします。また、彼らのテストの点数も正規分布に従っているとします。 このとき、「身長+点数」という確率変数を考えると、これは正規分布に従っているでしょうか? これを数学的に証明するのではなく、乱数を使ったシミュレーションで、「身長+点数もきっと正規分布に従うんじゃないか」ということを確認しようというわけです。 まずは↓こんな感じでデータを生成しておきます。 # 身長 # 平均 :170cm # 標準偏差: 5cm heights <- rnorm ( 100000 , 170 , 5 )   # 点数 # 平均 : 50 # 標準偏差: 10 scores <- rnorm ( 100000 , 50 , 10 ) ↓身長と点数のそれぞれでヒストグラムを描いてみましょう。 brk <- seq ( 0 , 300 , 1 ) # ヒストグラムの刻み hist ( heights , breaks=brk , ylim= c ( 0 , 10000 ) ) 正規分布に従う「身長」のヒストグラム hist ( scores , breaks=brk , ylim= c ( 0 , 10000 ) ) 正規分布に従う「点数」のヒストグラム ↓両者を足してヒストグラムを描いてみると、 hist ( heights + scores , breaks=brk , ylim= c ( 0 , 10000 ) ) 「身長+点数」は正規分布に従うか? どうやら正規分布になっているっぽいです。 では、どんな正規分布(平均、分散)になっているのでしょうか。 > mean(heights) [1] 169.9721 > mean(scores) [1] 50.04487 > mean(heights + scores) [1] 220.017 「身長...

Rでカイ二乗分布の確率密度関数のグラフをシミュレーション的に描く

イメージ
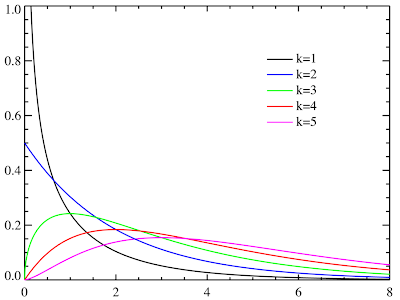
カイ二乗分布といえば、独立性の検定や適合度の検定で使ったりしますよね。 ウィキペディア には、確率密度関数のグラフが載っていて↓こんな感じ。 カイ二乗分布の確率密度関数のグラフ このグラフをRで描いてみようと、確率密度関数の式を見てみると、 ↑こんなのが載っていて、なんだかすごくむつかしい。Γ(ガンマ)関数ってのが出てきて、さらにそれは積分の形で定義されていたりして。 でもまあ、そのへんは理解できなくても、Rにはカイ二乗分布の確率密度関数(dchisq)が用意されているので、下記のようにすれば、ウィキペディアに載っていたのとそっくりのグラフが描けます。 curve ( dchisq ( x , 1 ) , xlim= c ( 0 , 8 ) , ylim= c ( 0 , 1 ) , col = "black" , ylab= "dchisq(x, k)" ) curve ( dchisq ( x , 2 ) , xlim= c ( 0 , 8 ) , ylim= c ( 0 , 1 ) , col = "blue" , add=T ) curve ( dchisq ( x , 3 ) , xlim= c ( 0 , 8 ) , ylim= c ( 0 , 1 ) , col = "green" , add=T ) curve ( dchisq ( x , 4 ) , xlim= c ( 0 , 8 ) , ylim= c ( 0 , 1 ) , col = "red" , add=T ) curve ( dchisq ( x , 5 ) , xlim= c ( 0 , 8 ) , ylim= c ( 0 , 1 ) , col = "magenta" , add=T )   #凡例 legend ( "topright" , lty= 1 , legend = c ( "k=1" , "k=2" , "k=3" , ...

Rで度数分布表を作る

イメージ
まずは今回のサンプル用として、身長っぽいデータを作ってみます。 a <- round ( rnorm ( 30 , mean = 170 , sd = 5 ) , 1 ) a   [ 1 ] 173.0 168.6 168.5 164.2 167.3 170.6 162.7 168.0 170.8 [ 10 ] 175.7 166.0 166.5 162.4 172.6 170.1 170.2 164.2 167.1 [ 19 ] 163.8 163.4 168.1 168.7 171.1 164.6 166.3 177.0 170.0 [ 28 ] 173.3 170.7 169.0 このaに対して、度数分布表を作りたい。 質的データ(カテゴリカルデータ)なら、table関数を使って度数を集計できるのですが、量的データに対してtableを使うと、↓こんな感じになってしまいます。 table ( a )   a 162.4 162.7 163.4 163.8 164.2 164.6 166 166.3 166.5 167.1 1 1 1 1 2 1 1 1 1 1 167.3 168 168.1 168.5 168.6 168.7 169 170 170.1 170.2 1 1 1 1 1 1 1 1 1 1 170.6 170.7 170.8 171.1 172.6 173 173.3 175.7 177 1 1 1 1 1 1 1 1 1 量的データだとうまくいかないですね。 Rには、お馴染みhist関数があるんで、ヒストグラムは簡単に描けます。 hist ( a ) 実は、このhist関数の戻り値のオブジェクトに各階級の度...

Rで円を描く方法あれこれ

イメージ
グラフに円を描くような関数が用意されていてもよさそうなものですが、どうもないみたいですので、自力で描く必要がありそうです。 簡単のため、半径1の円の例です。 まず思いつくのは、   x^2 + y^2 = 1 をyについて解いて、   y = ±√(1 - x^2) という関数の形にして、curve関数を使って描く方法でしょうか↓ curve関数で上側と下側を別々に描く curve ( sqrt ( 1 -x^ 2 ) , xlim= c ( - 1 , 1 ) , ylim= c ( - 1 , 1 ) , asp= 1 ) curve ( - sqrt ( 1 -x^ 2 ) , xlim= c ( - 1 , 1 ) , ylim= c ( - 1 , 1 ) , add=T ) 媒介変数表示を使うやり方もありますね。  x = cosθ  y = sinθ の、x と y の組を plotしていく感じです↓ 媒介変数で座標を求めたあとにプロット theta <- seq ( - pi , pi , length = 100 ) plot ( cos ( theta ) , sin ( theta ) , type= "l" , asp= 1 ) ちなみに type=l オプションを忘れると↓こんな感じになります。 点でプロットすると理屈が分かりやすい plot ( cos ( theta ) , sin ( theta ) , asp= 1 ) 何度も使う場合は、中心座標や半径を引数として関数化しておくといいですね↓ こんなところに隠れミッキーが!(自分で描いたくせに) plot.circle <- function ( x , y , r ) { theta <- seq ( - pi , pi , length = 100 ) points ( x + r* cos ( theta ) , y + r* sin ( theta ) , type= "l" , asp= 1 ) } plot ( c ( -...

Rの自己組織化マップ(SOM)で文字が重ならないようにする方法

イメージ
Rでsom関数を使って自己組織化マップを作った後、各ユニットの座標に文字列をplotした場合、同じユニットに配置された文字列の重なりが気になることってありますよね。 下記は、放送大学の 「データからの知識発見」という授業のテキスト からの引用です。 重なり対処を全く行っていない表示例 入門者向けの講義なので、サンプルコードのシンプルさを優先したのか、文字の重なりについての対処はありません。用いられていた入力のデータ数(動物の数)が14、同じ場所に配置されてしまったデータが最大で2個なので、なんとか読み取れます。ライオンとトラが重なると「ライトオン」っぽくなるというのはトリビアですね。 ただ、データ数が多くなって、3つも4つも重なってくると、読み取れなくなって実害が出てくると思います。 「 データマイニング入門 」(わたせせいぞうの表紙のシリーズのやつ)では、そこに一工夫されていて、$visualで得られる座標をそのまま使うのではなく、乱数を加えることによって、文字が全く同じ位置で重なることを避けています↓ 乱数による重なり対処を行った表示例 でも、そこはやはり乱数なので、うまく分離されているところもあれば、これじゃ読み取れないでしょってレベルのところもあります。 ↓以下は データマイニング入門 に載っていたサンプルをそのまま動かしたものです。 乱数による重なり対処を行った表示例(私の環境で実行させたもの) library ( som ) 動物データ 1 <- read.csv ( "animal1.csv" , header=T ) 標準化動物データ <- normalize ( 動物データ 1 [ , 2 : 14 ] , byrow=F ) 動物 SOM <- som ( 標準化動物データ , xdim= 10 , ydim= 10 , topol= "rect" ) 乱数 <- cbind ( rnorm ( nrow ( 動物データ 1 ) , 0 , 0.15 ) , rnorm ( nrow ( 動物データ 1 ) , 0 , 0.15 ) ) 動物マップ <- ...